Naar de inhoud
CataloomGratis audit aanvragen

Je weet welke kolom je wijzigt. Niet welk rapport daardoor omvalt.

Cataloom leest read-only mee met je SQL Server- of Azure SQL-warehouse en volgt elke kolom door views, procedures, temp-tabellen en MERGE-statements, tot in je Power BI-modellen en visuals. Bij elke stap staat de regel code die hem bewijst, en waar het spoor ophoudt staat een gat in plaats van een gok.

Halte 01 / 06Kolomspoor

Eén UPDATE, en Maandomzet valt om.

stg.PrijsFeed.Prijs > DimArtikel.Prijs > vw_Omzet.Omzet > Verkoop[Omzet] > Maandomzet. Bij elke stap de regel code die hem bewijst.

  • Alleen leesrechten
  • AI kan volledig uit
  • Losse HTML, geen login
  • Niets geïnstalleerd

Wat SQL Server je vertelt

dbo.DimArtikel
  • ArtikelKeyPK
  • Prijsdecimal
  • GewijzigdOpdatetime2
stg.PrijsFeed
  • ArtikelKeyint
  • Prijsdecimal

SQL Server houdt bij welk object welk object noemt. Niet welke bronkolom in welke doelkolom terechtkomt, en niets van wat Power BI ermee doet. Voor de vraag wat er omvalt als Prijs verandert, heb je hier een lijst namen en een middag zoekwerk.

Wat Cataloom uit de code haalt

UPDATE d
SET    d.Prijs = s.Prijs
FROM   dbo.DimArtikel d
JOIN   stg.PrijsFeed s ON s.ArtikelKey = d.ArtikelKey;
  1. stg.PrijsFeed.Prijsbron
  2. dbo.DimArtikel.PrijsUPDATE ... FROM, regel 2
    HOOG

    nondeterministic_update_from
    Op dit pad: de UPDATE bewijst niet dat stg.PrijsFeed één rij per ArtikelKey levert. Staan er twee, dan kiest SQL Server zwijgend een prijs, en die prijs eindigt in het visual.

  3. dbo.vw_Omzet.OmzetPrijs * Aantal, regel 7
  4. Verkoop[Omzet]semantic model
  5. Maandomzet / Omzet per regiorapport en visual

Cataloom ontleedt de T-SQL zelf: joins, UPDATE ... FROM, MERGE, temp-tabellen, CROSS APPLY. Elke stap op het spoor verwijst naar de regel code die hem maakt.

Wat het onderweg tegenkomt, zet het op de kaart. Deze UPDATE is een bevinding uit de audit, en omdat hij op het pad naar een rapport ligt, zie je meteen wie hem voelt als hij misgaat.

Zes vragen over je eigen warehouse

Beantwoord ze zonder SSMS te openen.

  1. 01Welke Power BI-rapporten breken als je die ene stagingtabel weggooit?
  2. 02Uit welke bronkolom komt het getal in je omzetvisual, en welke procedure rekent er onderweg aan?
  3. 03Welke stored procedure schrijft naar een tabel die niet in zijn naam staat?
  4. 04Welke views of procedures verwijzen naar een object dat niet meer bestaat?
  5. 05Naar welke van je _bak-tabellen wordt nog steeds geschreven?
  6. 06Wanneer klopte de documentatie voor het laatst?

Moest je bij meer dan twee gokken, dan is dat het gat. Het is geen kennisprobleem. Niemand houdt dit in zijn hoofd.

Elke lijn met bewijs. Elk gat met naam.

Een lineage-plaatje dat overal een lijn trekt, oogt compleet en is het niet. Cataloom zegt per kolom hoe zeker het spoor is.

aantoonbaar
313kolommen waarvan elke stap tot de bron uit de code volgt, met de regel erbij.
deels
37kolommen waarvan het spoor loopt, maar niet elke bron vast te stellen was. Het rapport zegt welke niet.
niet ondersteund
13procedures met dynamische SQL. Die staan er met naam in, in plaats van stil te ontbreken.

Gemeten op WideWorldImporters en WideWorldImportersDW samen: 350 kolommen, 89 procent volledig aantoonbaar. Op een productiewarehouse had elke kolom van het semantic model waar 50 rapporten aan hingen, 2.194 van de 2.194, een aantoonbare SQL-bron.

Volg zelf een kolom
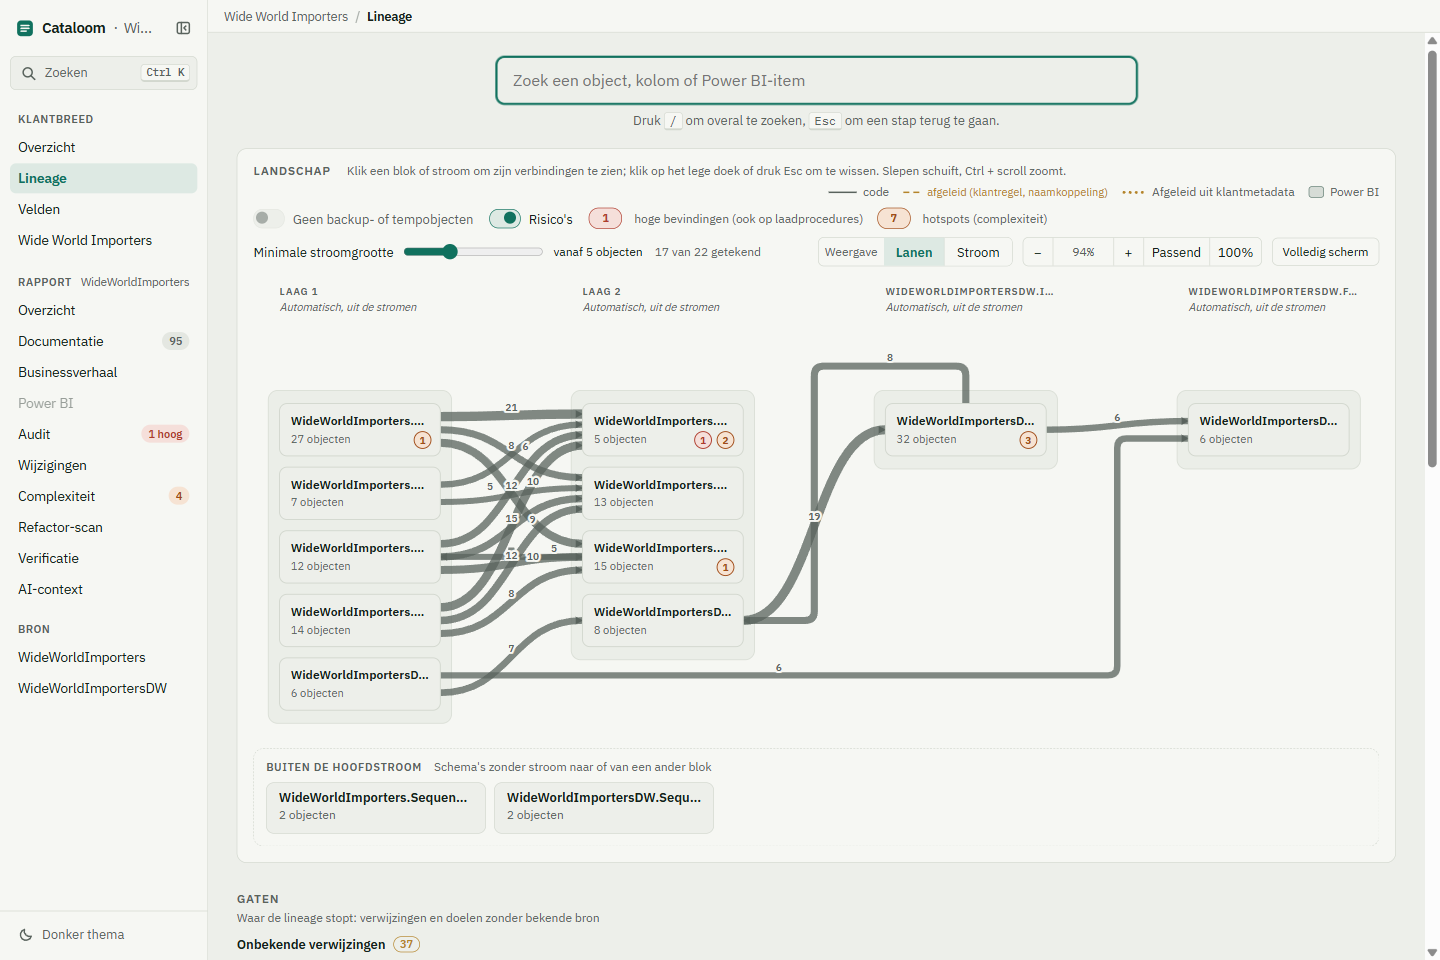
De lineage-app van Cataloom op WideWorldImporters en WideWorldImportersDW: schema's als blokken in lagen, stromen ertussen met het aantal verbindingen, en per blok het aantal bevindingen en complexiteits-hotspots.
de echte lineage-app, klik om te openen

Wat het bij anderen vond

Vier vondsten uit echte opdrachten. Tabelnamen zijn aangepast, het naampatroon en de datumstempels zijn echt.

584

visuals hingen aan één feittabel, terwijl op objectniveau alles aan alles leek te hangen

  • objectniveau 449 objecten raken 51 van 54 rapporten
  • kolomniveau Fact_Omzet 17 rapporten, 584 visuals
  • Dim_Rekening 18 rapporten, 254 visuals
  • Config.Omgeving 0 rapporten

Vijftig van de 54 rapporten hingen aan één model, dus op objectniveau raakte bijna elke tabel bijna elk rapport. Dat antwoord klopt en je kunt er niets mee. Pas op kolomniveau, tot op het visual, zie je welke wijziging echt telt.

6

vergeten tabellen in een productiewarehouse dat als goed onderhouden gold

  • Fact_Omzet_dd20241114
  • Dim_Rapportage_Frozen_temp
  • Dim_Contract_Aanname_Backup20250401
  • Fact_Omzet_Backup20250228
  • Dim_Rapportage_Frozen_BAK
  • Fact_Periode_Frozen_BAK

De eerste is een snapshot uit november 2024 die er veertien maanden later nog stond. Eén scan, geen AI aan te pas. Niemand in dat team kon zeggen waarom ze er nog waren.

107

semantic models en 156 rapporten hingen aan één database

  • 7 van de 8 databases: nul consumenten
  • 13 HIGH-bevindingen
  • modellen die een verdwenen object lezen

Zeven van de acht databases in die tenant werden door geen enkel rapport gelezen. Dertien bevindingen waren modellen die nog een object opvragen dat er niet meer is. Vóór de scan was dat van binnenuit niet te zien.

2.848

rijen voor de herschrijving, 2.699 erna

  • origineel 2.848 rijen
  • herschreven 2.699 rijen
  • verschil 149 rijen

Het model leverde een herschrijving die er bij review correct uitzag. De verificatiestap draaide beide versies read-only en vergeleek de resultaatsets. Daarom komt een herschrijving met een oordeel en niet met een belofte.

Dit draait op echte warehouses, niet op een testopstelling: de grootste die tot nu toe gescand is telde 765 objecten.

Wat je terugkrijgt

Een map HTML-bestanden. Geen login, geen CDN, geen enkele externe request. Open hem in 2030 en hij werkt nog.

objecten over 8 schema's
95
rijen, 403,6 MB
4,6 mln
relaties, uitgeschreven als zinnen
111
aan modelkosten voor de hele run
< € 1

De cijfers hierboven komen uit WideWorldImporters, de publieke voorbeelddatabase van Microsoft. Daarom kan ik je elk bestand laten zien in plaats van een uitgeveegde screenshot.

Open het echte rapport
De startpagina van het Cataloom-rapport over WideWorldImporters en WideWorldImportersDW: 149 objecten in twee bronnen, tegels voor 1 hoge bevinding, 7 complexiteits-hotspots, 0 geraakte rapporten en 89 procent aantoonbare kolomherkomst, met daaronder het landschap van de lineage tussen de schema's.
het echte rapport, klik om te openen

Een lijn tussen twee tabellen is nog geen lineage.

Dataedo, SchemaSpy en Redgate zetten je kolommen op een rij en geven je een veld om de beschrijving in te typen. Dat is nuttig, en het is een ander werk.

Een catalogus die lineage uit dependency-metadata haalt, kent objecten en geen kolommen. Een catalogus die hem uit query-logs haalt, kent alleen wat er onlangs draaide: een procedure die deze maand niet liep, bestaat daar niet.

Cataloom ontleedt de T-SQL zelf: de joins die een view echt maakt, de tabel waar een procedure en passant naartoe schrijft, de kolom die via een temp-tabel en een MERGE in je feittabel belandt.

Een procedure die UpdateEmployeeHireInfo heet, blijkt ook een regel toe te voegen aan de salarishistorie. Dat haal je nooit uit de naam en wel uit de code.

De optie waar de meeste teams voor kiezen is een Confluence-pagina die in 2023 klopte.

Hoe het gaat

  1. stap 1

    Je draait één script

    cataloom-collect.ps1 leest de systeemcatalogus en de objectdefinities. Je DBA leest hem in vijf minuten door. Hij schrijft een zip en verder niets.

  2. stap 2

    Je mailt me die zip

    Of je geeft me een login met db_datareader en VIEW DEFINITION en ik verbind read-only. Jouw keuze. De scriptroute bestaat omdat de meeste mensen op dag één geen login mogen uitdelen.

  3. stap 3

    Ik draai de analyse

    Ongeveer 800 objecten kosten 1,7 seconde aan de deterministische kant. De AI-stap duurt langer en kost minder dan een euro.

  4. stap 4

    Je krijgt het rapport terug

    Een map HTML-bestanden. Van jou, om te houden, door te sturen of te negeren.

Wat er wel en niet gebeurt

Alle details, inclusief de queries die het script draait

Read-only is een eigenschap van de verbinding

De connector heeft db_datareader en VIEW DEFINITION nodig. Voor indexgebruik komt daar VIEW DATABASE STATE bij. Ontbreekt een recht, dan zegt het rapport welk onderdeel is overgeslagen en waarom, in plaats van stil een gat te laten.

Welke AI, en op wiens kosten

In de gratis audit draait de AI-stap op mijn eigen Azure OpenAI-resource, op mijn kosten. In de doorlopende dienst draait hij op die van jou, met jouw sleutel. Zet de AI helemaal uit en alle veertien SQL-checks en de vier Power BI-checks werken nog, je krijgt alleen geen lopende tekst.

Geen losse rijen naar het model

De scan leest de catalogus en de definities. Voorbeeldrijen staan standaard uit. Bij een live verbinding gaan er voor het businessverhaal wel samenvattingen mee naar het model, zoals de waarden van een statuskolom met hun aantallen.

Wat er achterblijft

Na de gratis audit niets: geen agent, geen service, geen geplande taak in jouw omgeving. De zip en mijn kopie van het rapport verwijder ik 30 dagen na oplevering.

De grenzen

  • Cataloom repareert niets. Er is geen schrijfpad.
  • Herschrijvingen zijn voorstellen. De verificatiestap zegt welke een identieke resultaatset opleveren en welke hij niet kon controleren. Op WideWorldImporters: 4 gelijk, 0 verschillend, 15 die een sandbox nodig hebben. En van die 4 zijn er 3 gemeten op lege resultaatsets, wat het rapport als zwak signaal markeert en niet als bewijs. Hij zegt dus "sandbox nodig" in plaats van te gokken.
  • Het zegt niets over de vraag of een getal in een rapport zakelijk juist is. Het zegt of de SQL eronder verdedigbaar is.
  • Alleen SQL Server, Azure SQL en Synapse. Geen Fabric-warehouses, geen Snowflake, geen Postgres.
  • Versleutelde procedures kan niemand lezen, Cataloom ook niet. Het rapport noemt ze apart, zodat je ze niet verwart met objecten waar alleen het leesrecht ontbrak.
  • Dynamische SQL, een procedure die een querystring opbouwt en uitvoert, kan het niet ontleden. De lineage meldt zo'n stap als niet ondersteund in plaats van hem stil over te slaan, en met een regel in een lineage-bestand vul je het gat zelf.

Een audit is een foto. Je warehouse verandert elke sprint.

Bij een tweede run vergelijkt Cataloom met de vorige opname: nieuw, gewijzigd, hernoemd, verdwenen, plus welke Power BI-modellen dat raakt. Een sp_rename verschijnt als hernoemd en niet als verwijderd-plus-nieuw.

Op een productiewarehouse dat sinds augustus elke week draait, kwam de documentatie bij een herhaalde run volledig uit de cache: 0 verse modelcalls, 717 hergebruikt. Van de herschrijvingen was er 1 vers, tegen 118 hergebruikt. De doorlopende kosten zijn daarmee bijna nul. Waar je voor betaalt is dat iemand naar het verschil kijkt.

Hoe de doorlopende dienst werkt

Wat het kost

De gratis audit op één database kost niets en heeft geen staartje. Wil je dat het blijft draaien, dan begint Starter op € 750 per maand voor een klein team op één warehouse. Werken er meer mensen mee of loopt de keten door tot in Power BI, dan reken ik op omvang: gebruikers en databases, niet het soort organisatie.

Vragen die ik vaker krijg

Loopt de lineage ook zonder Power BI?

Ja. Zonder de Power BI-laag loopt het spoor van bron tot je laatste view of tabel. Met die laag erbij gaat het door tot in je semantic models, rapporten en visuals, ook via Analysis Services. Die laag vraagt toegang op tenantniveau, daarom zit hij niet in de gratis audit.

Die checks kan ik zelf ook schrijven

Klopt. Ze staan met naam en al op deze site. Wat je koopt is dat ze gebouwd, getest en doorlopend gedraaid worden, plus de verificatiestap die ving dat een herschrijving 2.699 in plaats van 2.848 rijen gaf.

Negen bevindingen op je eigen voorbeeld, waarvan één hoog. Dan vindt het dus niets?

WideWorldImporters is een schone voorbeelddatabase. Microsoft bouwde hem om functies te demonstreren, niet om acht jaar deadlines te overleven. Eén hoog, vier complexiteits-hotspots en vier ter informatie is het eerlijke resultaat en het verkeerde getal om Cataloom op af te rekenen. De audit is het meest waard waar het onderhoud het slechtst was.

Wij hebben al documentatie

Wanneer klopte die voor het laatst? Bij elke sprint schuift er iets. Daarom is de tweede run het eigenlijke product en niet de eerste.

Onze data mag niet naar een AI

Er gaan geen losse rijen heen. Wel schema, procedure-definities en, bij een live verbinding, een paar samenvattingen voor het businessverhaal, zoals de waarden van een statuskolom. In de gratis audit gaat dat naar mijn eigen Azure OpenAI-resource, in de doorlopende dienst naar die van jou. Draai je met de AI uit, dan blijven alle veertien SQL-checks en de vier Power BI-checks werken.

Ik mag geen tool op productie richten

Dan doe je dat niet. Je DBA leest cataloom-collect.ps1 in vijf minuten door, het doet alleen SELECT's op de systeemcatalogus, en jij mailt de zip. De databaseverbinding is de snellere route, niet de enige.

AI verzint dingen. Waarom zou ik die beschrijvingen vertrouwen?

Terechte vraag. Relaties en lineage worden deterministisch uit de code gemined, met het bewijs eronder. Het businessverhaal toetst zijn eigen onderbouwing en zakt in zekerheid als het bewijs niet draagt. Herschrijvingen zijn expliciet voorstellen met een geverifieerd oordeel.

Hoeveel tijd kost dit mijn team?

Ongeveer twintig minuten van jouw tijd. Het script draait in een minuut, de scan doet 800 objecten in 1,7 seconde. De analyse doe ik.

Werkt dit op Fabric of Snowflake?

Nee. SQL Server, Azure SQL en Synapse.

Kies de tabel waar je het minst graag aankomt. Ik laat zien wat eraan hangt.

Geen gesprek nodig vooraf en geen verplichting achteraf. Wil je dat het blijft draaien, dan praten we daarna.